Die Diskrepanz zwischen theoretischen Spitzenwerten in standardisierten Benchmarks und den tatsächlichen Ergebnissen im Softwarealltag wächst spürbar. In der ersten Episode des Expertenformats High Taste Testers von Latent Space diskutierten Branchenkenner wie Swyx, Alex Volkov und Dex Horthy über die realen Hürden beim Rollout autonomer Systeme. Statt weiterer Leistungssprünge bei großen Basismodellen standen vor allem operative Fehlerquellen und architektonische Schwachstellen im Mittelpunkt der Debatte. Die Experten machten deutlich, dass der praktische Nutzen von Agenten derzeit vor allem an Verifikationsfragen und unzureichender Kontrollinfrastruktur scheitert.
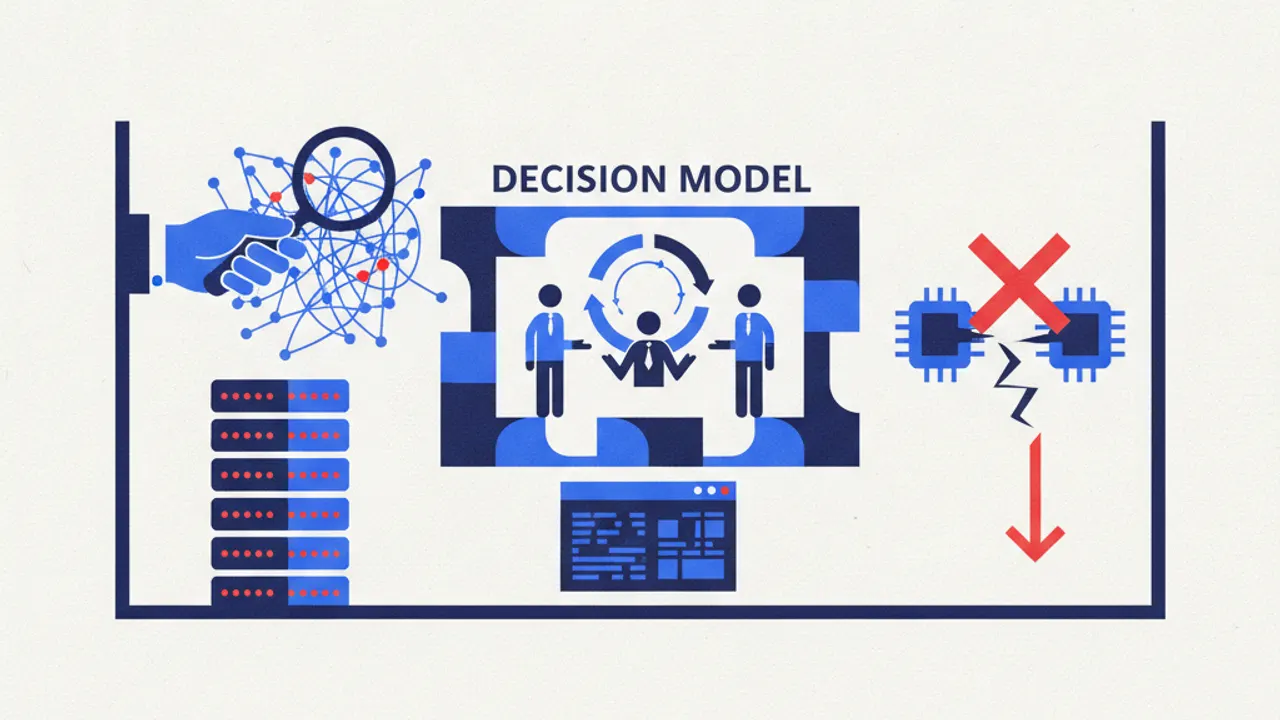
Ein zentraler Diskussionspunkt war die sogenannte Verifikationskrise bei autonomen Programmier-Agenten. Wenn Entwickleragenten in unregulierten Schleifen über Nacht laufen gelassen werden, scheitert der Prozess selten an der reinen Modellausgabe. Das eigentliche Problem offenbart sich am nächsten Morgen, wenn Entwicklungsteams von hunderten generierten Pull Requests überrollt werden. Da kein menschlicher Ingenieur diese Masse an Änderungen im Detail prüfen kann, verkehrt sich der versprochene Produktivitätsgewinn schnell in eine personelle Überlastung. Ohne automatisierte und verlässliche Testumgebungen bleiben solche autonomen Schleifen in der Praxis kaum handhabbar.
Neben der Flut ungeprüften Codes identifizierten die Diskutanten den sogenannten Memory Drift als gravierende Schwachstelle agentischer Assistenten. Im Produktiveinsatz verlieren Agenten über verteilte Client-Sitzungen hinweg häufig den relevanten Kontext. Diese schleichende Entkopplung von vorherigen Absprachen und Systemzuständen führt zu inkonsistenten Ergebnissen und schwer reproduzierbaren Fehlern. Für Unternehmen, die Agenten in komplexe Bestandssysteme integrieren wollen, stellt dieser Mangel an deterministischer Beständigkeit ein erhebliches Risiko dar.
Um den Betrieb überhaupt wirtschaftlich zu halten, vollzieht sich laut der Expertenrunde eine grundlegende Verschiebung bei den Modellarchitekturen. Während früher für jeden Teilschritt auf teure Frontier-Reasoning-Modelle zurückgegriffen wurde, setzen Entwickler nun verstärkt auf spezialisierte Decision Models. Diese extrem kompakten Klassifikatoren und Router übernehmen gezielt einzelne Verzweigungen und Entscheidungsbäume in komplexen Arbeitsabläufen. Das entlastet die großen Basismodelle und verringert die Latenzzeiten bei wiederkehrenden Routineaufgaben spürbar.
Als konkrete Beispiele für diesen Trend wurden Modelle wie Liquid d1-ultra, Perplexity pplx-decider sowie Jev von TypeSafe genannt. Diese spezialisierten Bausteine senken die anfallenden Inferenzkosten um den Faktor 10 bis 20 im Vergleich zu herkömmlichen Flaggschiffmodellen. Durch den gezielten Einsatz kompakter Router können Entwicklungsteams komplexe Agenten-Pipelines aufbauen, ohne dass die API-Rechnungen unkontrolliert explodieren. Der Wandel markiert einen Übergang von monolithischen Modellaufrufen hin zu modular orchestrierten Netzwerken kleinerer Spezialsysteme.
Die Erkenntnisse aus der Runde verdeutlichen, dass der Hype um autonome Agenten einer nüchternen Ingenieurpraxis weichen muss. Der Erfolg agentischer Software hängt künftig weniger von marginalen Benchmark-Verbesserungen der Modellanbieter ab, sondern von robuster Middleware, strenger Verifikation und kosteneffizientem Routing. Für Softwareabteilungen bedeutet dies eine Neuausrichtung ihrer Ressourcen weg vom reinen Prompting hin zur Systemarchitektur. Erst wenn Test- und Kontrollmechanismen mit der Generierungsgeschwindigkeit Schritt halten, wird der breite Produktiveinsatz wirtschaftlich tragfähig.