In deutschen Unternehmen führt der Produktiveinsatz generativer Sprachmodelle zunehmend zu unerwarteten Budgetbelastungen. Obwohl die nominalen Listenpreise für einzelne API-Tokens am Markt stetig sinken, beobachten viele Betriebe eine deutliche Kostenexplosion im Regelbetrieb. Wie aktuelle Branchenberichte und Erhebungen von FAZ und Golem zeigen, steuern die Gesamtausgaben für generative KI in Deutschland rasant auf ein geschätztes Volumen von rund 11,5 Milliarden Euro zu. Die hohe Frequenz automatisierter Anfragen und der wachsende Datenverkehr treiben die Rechnungen der Cloud- und Modellanbieter massiv in die Höhe.
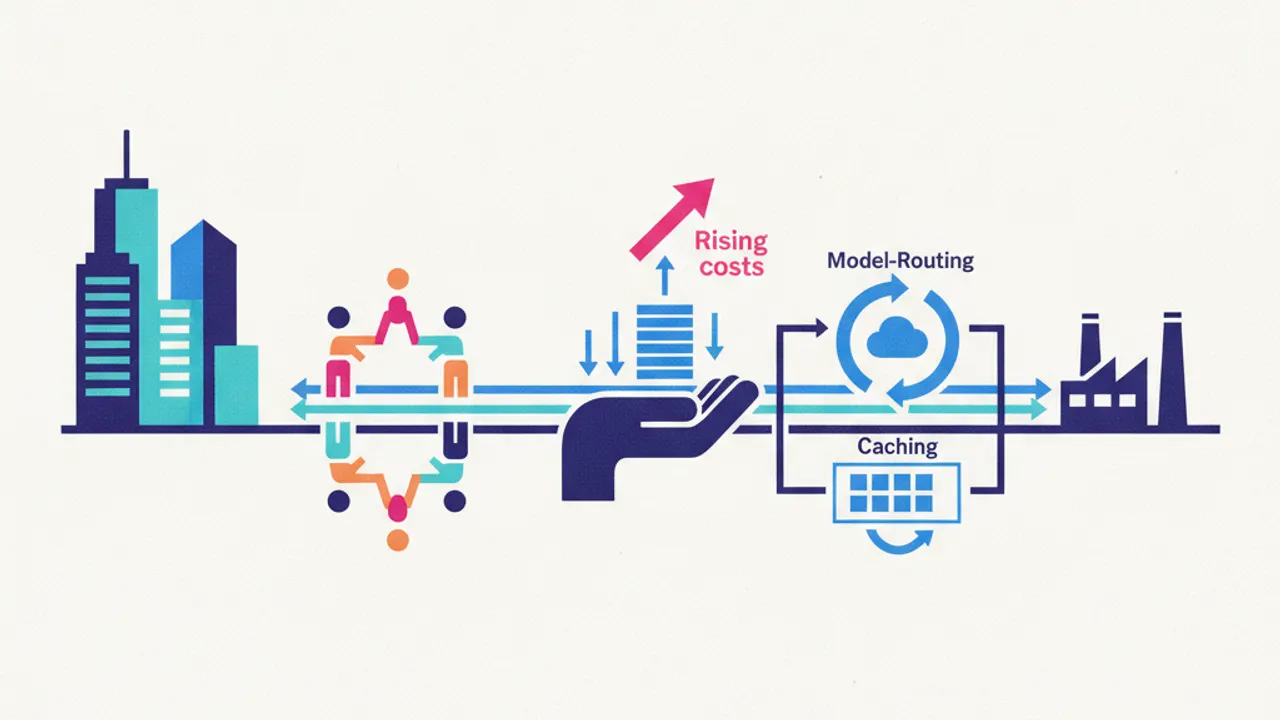
Um ihre operativen Margen und den Return on Investment (ROI) nicht zu gefährden, verändern führende DAX-Konzerne nun ihre technische Architektur. Anstelle eines pauschalen Zugriffs auf die leistungsfähigsten, aber teuersten Frontier-Modelle greifen Unternehmen wie beispielsweise Siemens zu differenzierten Gegenmaßnahmen. Die zentrale Säule bildet dabei ein dynamisches Model-Routing, bei dem eingehende Anfragen systematisch vorgefiltert und analysiert werden.
Im Rahmen dieser Routing-Architekturen werden einfache Aufgaben standardmäßig an kleinere, hochgradig spezialisierte Modelle weitergeleitet, die mit einem Bruchteil der Rechenleistung auskommen. Nur wenn eine Anfrage komplexe logische Schlüsse oder domänenspezifisches Tiefenwissen erfordert, erfolgt eine automatische Eskalation an teurere Flaggschiffmodelle. Dieser mehrstufige Ansatz reduziert das verbrauchte Token-Volumen bei Frontier-Systemen spürbar und verhindert unnötig teure API-Aufrufe bei Routineaufgaben.
Ergänzt wird die Strategie durch ein rigoroses Prompt-Caching. Wiederkehrende Systemanweisungen, statische Kontextdaten und standardisierte Unternehmensrichtlinien werden dabei im Speicher gehalten, anstatt bei jedem einzelnen Aufruf erneut vollständig über die Schnittstelle übertragen und abgerechnet zu werden. Diese Maßnahme dämpft die laufenden API-Kosten zusätzlich und verringert zugleich die Latenzzeiten in kunden- und mitarbeitergerichteten Anwendungen.
Die Entwicklungen markieren einen spürbaren Reifeprozess in der industriellen KI-Nutzung. Während in den ersten Erprobungsphasen oft die schiere Leistungsfähigkeit der größten Modelle im Vordergrund stand, rückt in der Skalierungsphase nun die betriebswirtschaftliche Effizienz in den Fokus. IT-Verantwortliche stehen vor der Herausforderung, eine feine Balance zwischen Modellqualität und Kostendisziplin zu etablieren, um die langfristige Wirtschaftlichkeit ihrer generativen Systeme zu sichern.