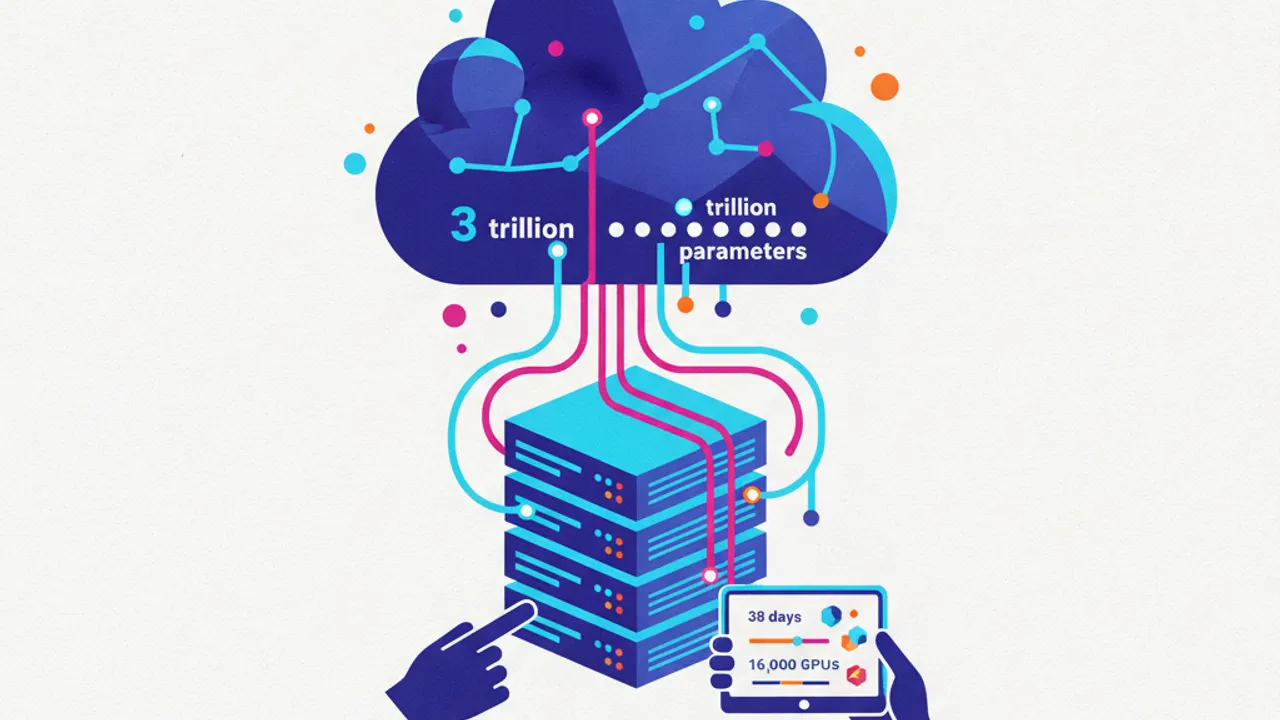
Die KI-Sparte von Microsoft unter der Leitung von Mustafa Suleyman hat technische Einblicke in das Pre-Training ihres bisher größten internen Basismodells namens MAI-Base-2 gewährt. Das Mixture-of-Experts-System markiert einen zentralen strategischen Schritt des Konzerns, um neben bestehenden Partnerschaften eine vollständige eigene Modellfamilie an der technologischen Leistungsspitze zu etablieren. Mit einer Gesamtgröße von 2,8 bis 3 Billionen Parametern positioniert sich MAI-Base-2 direkt in der Liga gigantischer Frontier-Modelle. Zugleich gibt der Konzern seltene Einblicke in die physikalischen und rechnerischen Dimensionen seiner aktuellen Forschungsinfrastruktur.
Trotz der immensen Gesamtkapazität von fast drei Billionen Parametern setzt die Architektur auf eine ausgeprägte Sparsity. Pro verarbeitetem Token sind lediglich etwa 80 Milliarden Parameter aktiv, was die Rechenkosten pro Inferenzschritt im Vergleich zu dichten Modellen drastisch begrenzt. Als strukturelle Komponenten kommen unter anderem Sliding-Window-Attention sowie eine dedizierte Gradientenbegrenzung zum Einsatz. Bei der Optimierung vertraute das Entwicklungsteam auf den neuartigen Muon-Optimierer, welcher die Trainingsstabilität bei extremen Parameterskalierungen gewährleisten soll.
Der Trainingslauf verdeutlicht die gewaltigen Hardware-Ressourcen, die Hyperscaler derzeit in ihren Rechenzentren bündeln. Microsoft trainierte MAI-Base-2 auf einem homogenen Großcluster aus 16.000 Nvidia GB200 NVL72-Beschleunigern. Der gesamte Pre-Training-Prozess wurde in einer Rekordzeit von lediglich 38 Tagen abgeschlossen. Dieser Zeitrahmen belegt nicht nur die Rohleistung der Blackwell-Architektur, sondern spiegelt auch erhebliche Fortschritte in der Netzwerktopologie und bei der Vermeidung von Trainingsunterbrechungen wider.
In internen Evaluierungen stellt Microsoft vor allem signifikante Effizienzgewinne gegenüber der Konkurrenz heraus. Nach Angaben des Unternehmens beansprucht die Architektur bei Programmier-Benchmarks eine bis zu zwölffach höhere FLOP-Effizienz im Vergleich zu DeepSeek-V4-Pro-Base. Diese Kennzahl deutet darauf hin, dass die Kombination aus MoE-Routing, Muon-Optimierung und kuratierten Trainingsdaten den Bedarf an reiner Brute-Force-Rechenleistung zur Erzielung logischer Fähigkeiten spürbar reduziert. Solche Effizienzsprünge sind die Voraussetzung dafür, Multi-Billionen-Systeme überhaupt ökonomisch tragfähig zu betreiben.
Die kommerzielle Verwertung des Modells ist fest in Microsofts Cloud-Ökosystem verankert. Ausgewählte Post-Training-Checkpoints von MAI-Base-2 sollen schrittweise über die Plattform Azure AI Foundry für Geschäftskunden bereitgestellt werden. Für Microsoft bedeutet dieser Schritt eine spürbar stärkere Unabhängigkeit von externen Modellanbietern wie OpenAI. Der Softwarekonzern sichert sich damit die technologische Hoheit über den gesamten Stack, von der Hardware-Verwaltung bis zur Endkundenanwendung.
Die Veröffentlichung unterstreicht das anhaltende Wettrüsten um Multi-Billionen-Parameter-Architekturen unter den führenden Technologiekonzernen. Während kompakte On-Device-Modelle und spezialisierte Classifier für Routineaufgaben immer wichtiger werden, bleiben gigantische Basissysteme das Fundament für komplexe Reasoning-Fähigkeiten und autonome Agenten. Gleichzeitig treibt das Training solcher Systeme den weltweiten Energiebedarf in neue Höhen, was die Debatte um die Bereitstellung von Gigawatt-Kapazitäten für kommende Modellgenerationen weiter anheizt.