Trotz rasanter Fortschritte bei generativen Videomodellen wie Veo, Sora oder Gen-3 stieß die automatisierte Erstellung narrativer Langfilme bislang an enge technologische Grenzen. Während moderne Diffusionsmodelle visuell beeindruckende Einzelclips von wenigen Sekunden Dauer erzeugen können, scheiterten zusammenhängende Erzählungen regelmäßig an zwei Kernproblemen: dem sogenannten Semantic Drift, bei dem Gesichter, Kleidungsstücke oder Kulissen zwischen Schnitten schleichend mutieren, sowie an fatalen Kaskadenfehlern, bei denen ein einzelnes fehlerhaftes Bild die gesamte Folgesequenz unbrauchbar macht. Google Research hat nun eine modulare Lösung vorgestellt, die Filmregie nicht als reine Bildsynthese, sondern als komplexes Problem der Orchestrierung und des visuellen Gedächtnisses begreift.
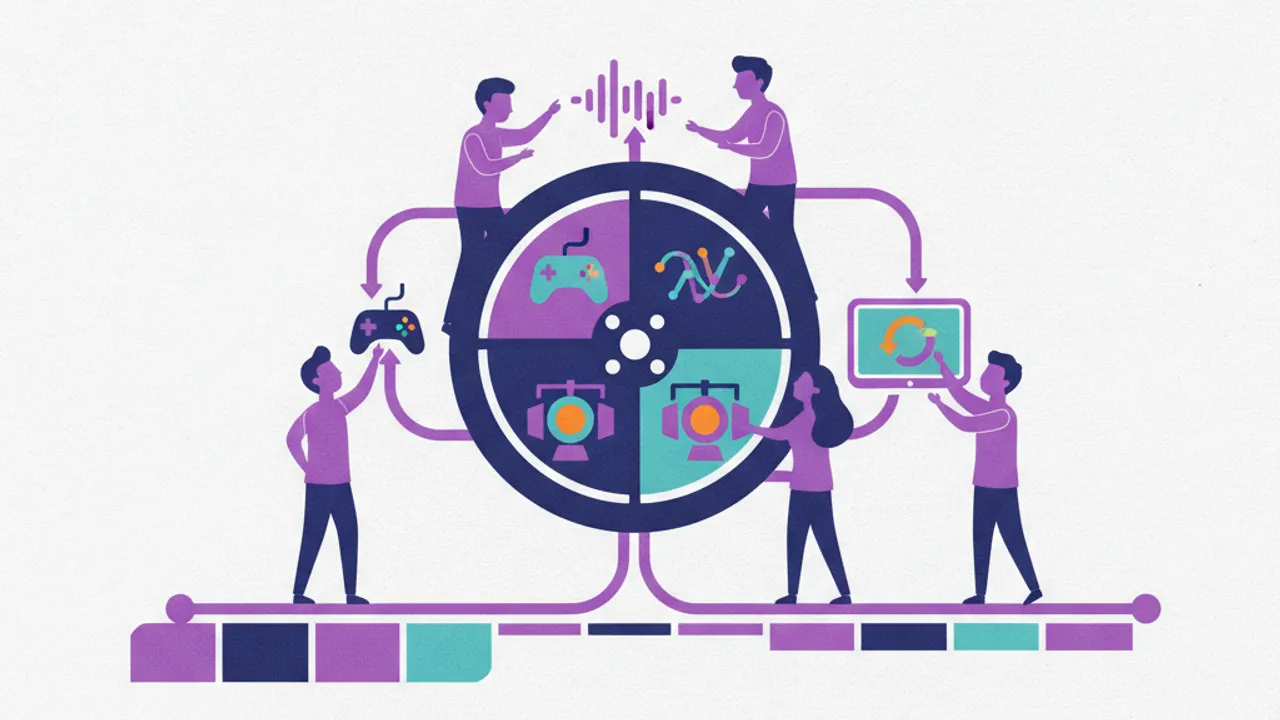
Das am 24. September vorgestellte System firmiert unter dem Titel AI Video Co-Director und verknüpft Googles multimodales Sprachmodell Gemini mit dem Videogenerator Veo. Das Gesamtsystem gliedert sich in vier spezialisierte Komponenten, die arbeitsteilig vorgehen. Den Einstieg bildet das Modul Co-Director, das auf der Konferenz COLM 2026 vorgestellt wurde. Es nutzt Optimierungsansätze aus dem Bereich der Multi-Armed Bandits, um aus einem kreativen Textbriefing selbstständig narrative Strategien, visuelle Ästhetiken und kohärente Storyboards abzuleiten.
Das chronische Konsistenzproblem adressiert die zweite Säule des Frameworks namens CANVAS, das auf der EMNLP 2026 präsentiert wurde. CANVAS fungiert als persistenter visueller Speicher, der Figurenkonstellationen, Requisiten und Raumgeometrien über fortlaufende Szenenwechsel hinweg explizit verankert und abrufbar hält. Anstatt das Modell jede Einstellung aus dem Nichts neu erraten zu lassen, erzwingt dieser Speicher eine geometrische und personelle Kontinuität, wie sie in klassischen Filmproduktionen von Script Supervisors überwacht wird.
Für die eigentliche Bild- und Szenenerzeugung kommt der Mechanismus Agentic Autoregressive Diffusion (A²RD) zum Einsatz. Diese Komponente erzeugt Sequenzen segmentweise und autoregressiv, wodurch längere zusammenhängende Szenenketten stabil bleiben. Zur Demonstration des Ansatzes produzierte Google Research einen zehn Minuten langen, zusammenhängenden Kurzfilm, in dem handelnde Figuren und Schauplätze ohne sichtbaren Qualitätsabfall konsistent blieben. Dies markiert einen beachtlichen Schritt gegenüber den bisher üblichen Zusammenschnitten disparater Kurzsequenzen.
Abgerundet wird die Pipeline durch das visuelle Prüfmodul VQQA (Visual Question Answering Quality Assurance). Dieses Werkzeug agiert wie ein digitaler Schnittassistent, der gerenderte Frames auf Kontinuitätsbrüche, physikalische Absurditäten oder Schnittfehler analysiert und bei Abweichungen gezielte Korrekturschleifen an die vorgelagerten Diffusionsschritte zurückmeldet. Zudem versieht Google sämtliche erzeugten Videodaten nativ mit dem hauseigenen SynthID-Wasserzeichen, um die Herkunft der synthetischen Medien manipulationssicher zu dokumentieren.
Mit dem AI Video Co-Director verschiebt sich der Fokus in der KI-Bewegtbildforschung merklich von der reinen Rohmodell-Skalierung hin zu übergeordneten Steuerungsschichten. Indem Google das kreative Handwerk in Planung, visuelle Gedächtnisführung, Bildgenerierung und iterative Endkontrolle zerlegt, demonstriert der Konzern, wie Multi-Agenten-Pipelines das Zusammenspiel bestehender Großmodelle für professionelle Produktionsketten nutzbar machen können.