In der modernen Softwareentwicklung vollzieht sich ein grundlegender Wandel bei der Überprüfung von Quellcode. Die Anthropic-Ingenieure Addy Osmani, Morgan Westlee Lunt und Qing Wang haben detaillierte Einblicke in die Arbeitsprozesse des Claude-Code-Teams veröffentlicht. In einem Beitrag mit dem Titel 'How the Claude Code team does code review' legt die Gruppe dar, wie Ingenieure agieren, wenn mehr als 90 Prozent des produzierten Codes von generativen Sprachmodellen geschrieben werden. Das Team zeigt auf, wie durchdachte Automatisierung das klassische Peer-Reviewing entlastet, anstatt blindes Vertrauen in Modelle vorauszusetzen.
Wenn der Großteil des Codes von KI-Systemen stammt, geraten herkömmliche Pull-Request-Prozesse schnell an ihre Belastungsgrenzen. Menschliche Entwickler können die Fülle an Codeänderungen kaum noch Zeile für Zeile auf subtile Logikfehler überprüfen, ohne dass gravierende Engpässe entstehen. Das Team um Osmani reagierte darauf mit einem Paradigmenwechsel, der von bloßer manueller Kontrolle zu einer architekturellen Risikosteuerung übergeht. Anstatt jede Routinezeile von Hand abzutippen oder mühsam freizugeben, werden wiederkehrende Prüfschritte an spezialisierte Instanzen delegiert.
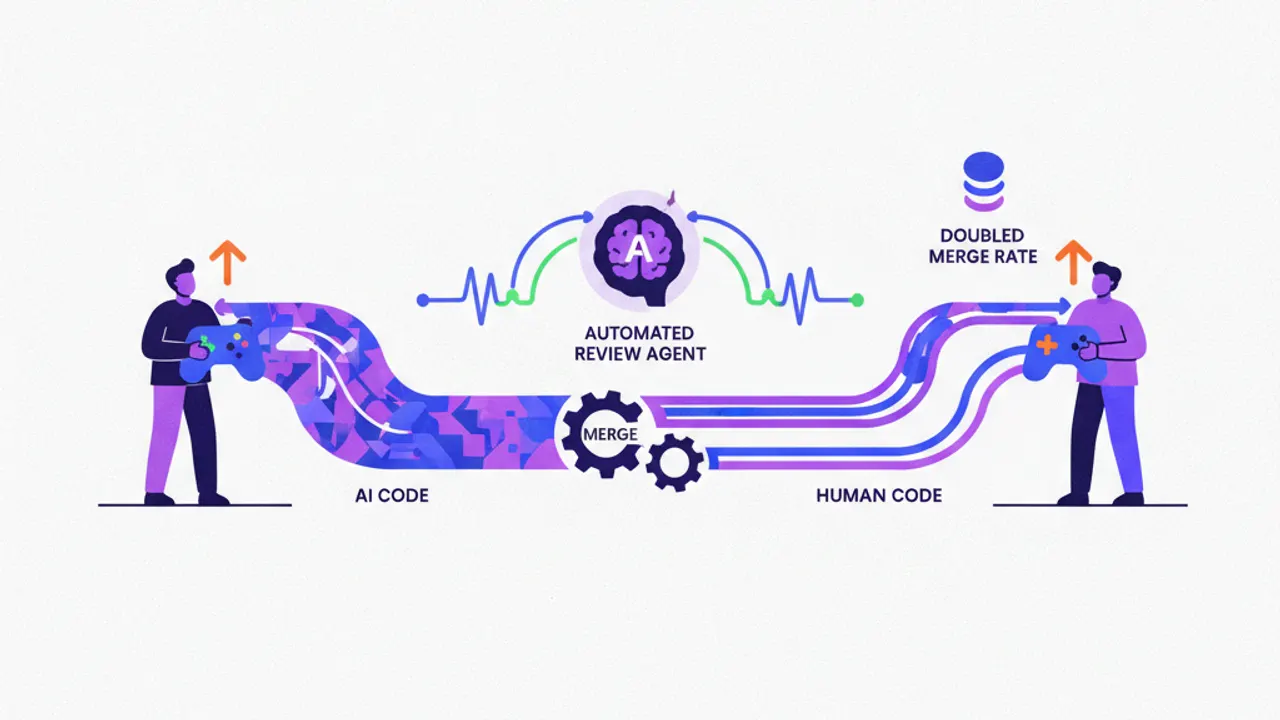
Kern dieser Methodik ist ein mehrstufiges Prüfsystem, das auf automatisierten Review-Agenten und klaren Risikoklassifizierungen aufbaut. Eingehender Code wird nicht pauschal gleich behandelt, sondern anhand seines potenziellen Schadensausmaßes in Risikostufen unterteilt. Kritische Systembereiche, Sicherheitsarchitekturen und komplexe Datenstrukturen erfordern weiterhin intensive menschliche Prüfungen, während isolierte Änderungen mit geringem Risiko durch automatisierte Agenten vorab validiert werden. Die Agenten scannen die Änderungen auf Konsistenz, Einhaltung von Stilrichtlinien und bekannte Schwachstellen.
Die praktischen Resultate dieses hybriden Ansatzes belegen eine spürbare Effizienzsteigerung im Entwicklungstempo. Zwischen Juni und September 2026 konnte das Claude-Code-Team die Anzahl der erfolgreich gemergeten Pull-Requests verdoppeln. Dieser Zuwachs beruhte nicht auf einer Absenkung der Qualitätsstandards, sondern auf der Beschleunigung von Freigabeprozessen für unkritische Codeabschnitte. Entwickler konnten sich dadurch auf strategische Designentscheidungen und übergeordnete Systemarchitekturen konzentrieren.
Gleichzeitig widerlegt die Statistik die Befürchtung, dass eine hohe KI-Beteiligung unweigerlich zu mehr Fehlern in Produktionsumgebungen führt. Trotz des verdoppelten Durchsatzes an Pull-Requests sanken die Code-Reverts im selben Zeitraum um mehr als 40 Prozent. Die strukturierte Risikobewertung in Kombination mit mehrstufigen Agentenprüfungen filterte fehlerhafte Annahmen der generativen Modelle heraus, bevor sie in den Hauptzweig der Repositorien gelangten. Dies belegt, dass KI-gestützte Entwicklung bei sauberer Governance die Codequalität sogar stabilisieren kann.