Amazon SageMaker AI: Messwerte sollen Schätzungen beim Autoscaling von TTS-Modellen ersetzen
Bei Text-to-Speech-Modellen auf Amazon SageMaker AI ersetzt ein messbasierter Ansatz mit Parametern wie Q_max und T_total das bisherige Raten bei Autoscaling-Grenzwerten.
Dieser Beitrag wurde KI-generiert und automatisch veröffentlicht. Einordnung, Kennzeichnung und alle Quellen am Beitragsende.
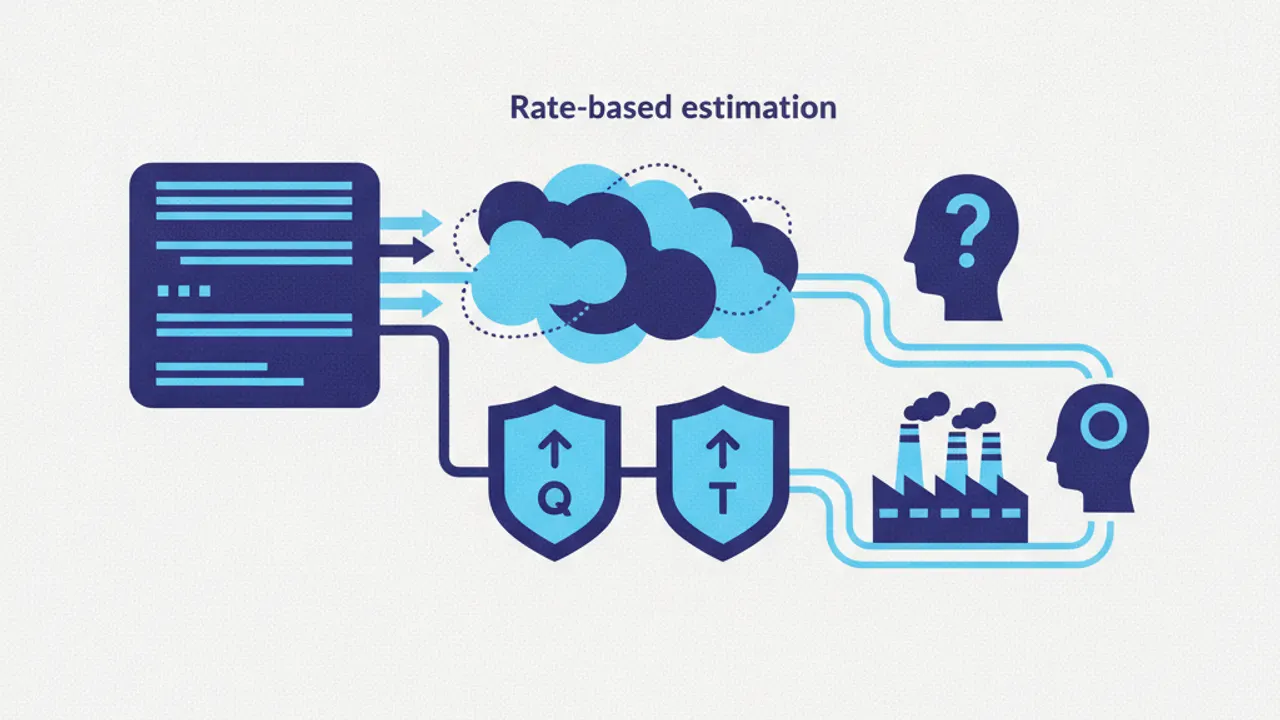
(KI-generiertes Symbolbild: Gemini / AI Connect)
Beim Einsatz eigener Text-to-Speech-Modelle auf Amazon SageMaker AI greifen Entwicklungsteams bei den Schwellenwerten für die automatische Skalierung häufig auf bloße Vermutungen zurück. Dieses Vorgehen birgt für den laufenden Betrieb erhebliche wirtschaftliche und technische Risiken. Eine fehlerhafte Schätzung hat zur Folge, dass entweder teure Ausgaben für Grafikprozessoren ungenutzt verpuffen oder vereinbarte Service Level Objectives bezüglich der Latenzzeit verfehlt werden.
Als Alternative zu dieser Schätzpraxis wird nun die Bereitstellung des Modells Kokoro-82M in einem spezifischen Container beschrieben. Statt willkürlicher Annahmen ermöglicht das Verfahren eine gemessene Richtlinie für das Autoscaling. Die Grundlage für diese Ausrichtung bilden zwei konkrete Messgrößen des aktiven Endpunkts, die als Q_max und T_total erfasst werden.
Was heißt das für Sie?
Für Unternehmen, die Sprachmodelle in der Cloud betreiben, bietet dieser messbasierte Ansatz eine verlässliche Methode zur Kostenkontrolle von teuren GPU-Ressourcen. Sie vermeiden dadurch das finanzielle Risiko von Überprovisionierung, ohne Abstriche bei der Einhaltung vertraglicher Latenzzusagen machen zu müssen. Die systematische Erfassung spezifischer Endpunkt-Metriken liefert hierbei belastbarere Grundlagen als grobe Faustregeln.
Belege
Solide belegt
Beleg-Score
46/100
Teams, die eigene Text-to-Speech-Modelle auf Amazon SageMaker AI betreiben, schätzen die Schwellenwerte für die Skalierung oft nur ab.
eine Quelle
Zitat
„Teams deploying custom text-to-speech models on Amazon SageMaker AI often guess at autoscaling thresholds“
Der Beleg-Score wird berechnet, nicht handgesetzt: aus Vertrauensgrad, Quellenzahl und dem Anteil verifizierter Aussagen.
Quelle & Transparenz
Stand: 22. Oktober 2026
KI-generiertKI-generiert: automatisiert aus geprüften Quellen erstellt und technisch qualitätsgesichert (Quellen-, Zitat- und Zahlenabgleich); keine menschliche Einzelfreigabe vor Veröffentlichung
Hallo! Ich bin der KI-Assistent von AI Connect. Ich beantworte Ihre Fragen zur Anbieter-Suche, zur KI-Projekt-Analyse und zu KI-Lösungen. Wie kann ich Ihnen helfen?
Sie chatten mit einer KI. Antworten werden automatisiert erstellt, können Fehler enthalten und sind keine Rechts- oder sonstige Beratung. Bitte keine sensiblen personenbezogenen Daten eingeben.