Das US-Startup TypeSafe AI hat nach zweijähriger Entwicklungsphase sein Modell Jev veröffentlicht. Gegründet wurde das Unternehmen von dem ehemaligen OpenAI-Forscher Diogo Almeida, der als Miterfinder von RLHF und InstructGPT gilt, gemeinsam mit Sasha Sheng und Erik Gafni. Mit Jev verfolgt das Gründerteam einen grundlegend neuen Ansatz, der sich von gängigen generativen Sprachmodellen unterscheidet. Statt neue Texte autoregressiv Wort für Wort zu generieren, agiert das System als spezialisiertes Entscheidungsmodell für Software-Pipelines.
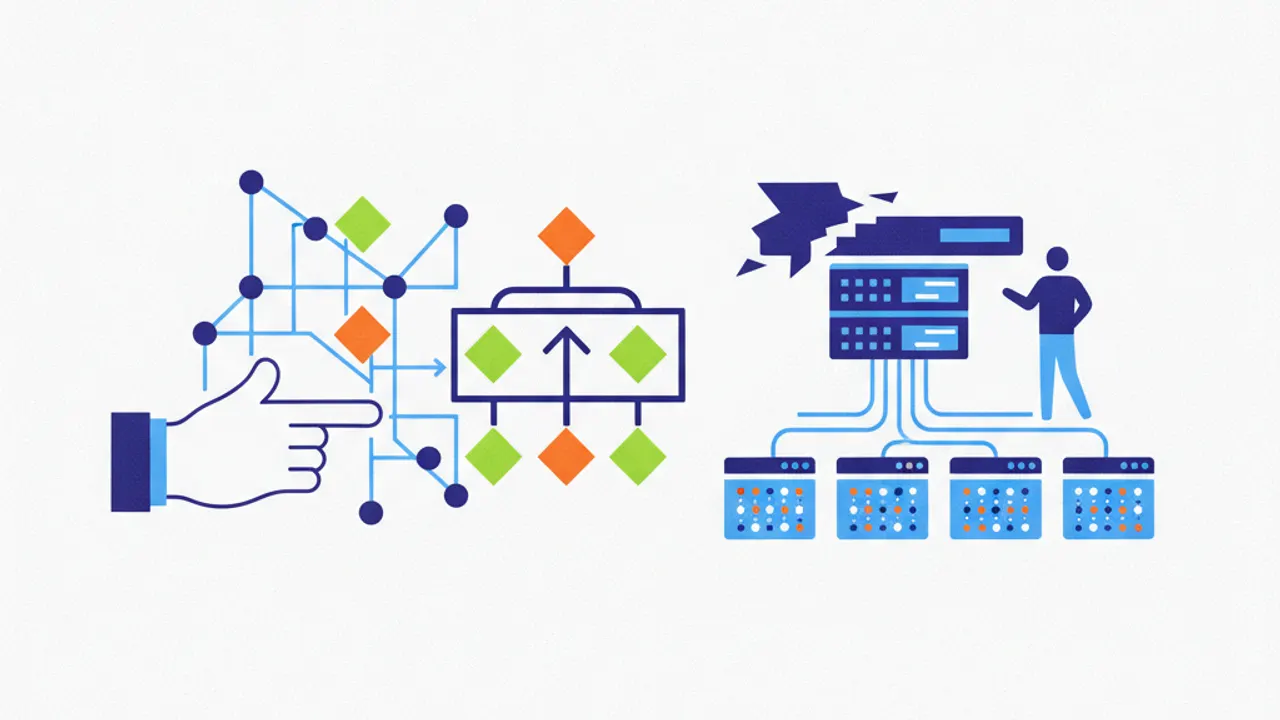
Konzeptionell stützt sich Jev auf die Theorie des schnellen Denkens, die der Psychologe Daniel Kahneman als System 1 beschrieben hat. Entwickler übergeben dem System unstrukturierte Daten, etwa Fließtext oder komplexe JSON-Objekte, zusammen mit klar getypten Abfragen. Jev berechnet daraufhin parallele, probabilistisch kalibrierte Antworten, ohne dabei ausschweifende Erklärungen zu formulieren. Das Modell verarbeitet Anfragen direkt als logische Entscheidungseinheit, was den Einsatz in autonomen Steuerungsstrukturen vereinfachen soll.
Die Modellausgaben sind auf drei fundamentale Primitive beschränkt, um strikte Vorhersehbarkeit im Programmcode zu garantieren. Dazu gehört das Primitiv Choice für diskrete Auswahlen aus vorgegebenen Optionen sowie Score für abgestufte Bewertungen auf einer Skala. Das dritte Primitiv namens Noul dient der Ermittlung kalibrierter Wahrscheinlichkeiten für Ja-Nein-Entscheidungen. Software-Entwickler erhalten dadurch typisierte Rückgabewerte, die ohne aufwendiges Prompt-Engineering oder nachgelagertes Regex-Parsing direkt in Programmabläufe übernommen werden können.
Durch den Verzicht auf die sequenzielle Generierung von Text-Tokens erzielt das System erhebliche Geschwindigkeitsvorteile. Die gemessenen Latenzzeiten bewegen sich zwischen 70 und 500 Millisekunden pro Durchlauf. Bei typischen Klassifizierungsaufgaben arbeitet Jev damit 20- bis 200-mal schneller als klassische Frontier-Modelle. Da keine Antwort-Tokens berechnet werden müssen, entfallen die üblichen Flaschenhälse beim Streaming langer Modellausgaben.
Auch das Preismodell bricht mit den Konventionen der Branche. TypeSafe AI verlangt 0,042 US-Dollar pro einer Million Eingabe-Tokens, während die eigentliche Ausgabe vollständig kostenlos bleibt. Für Entwickler von KI-Agenten reduzieren sich die Betriebskosten dadurch drastisch, da Routing- und Entscheidungsschritte in Agentenschleifen zu einem Bruchteil der bisherigen Kosten realisiert werden können. Das Modell positioniert sich damit als performanter Kontrollbaustein für mehrstufige Agentensysteme.